
Pytanie
Oznaczenia wideo chirurgicznego na poziomie pikseli powstają powoli, a granice narzędzi są w nich najmniej spójne. Renderer daje dowolnie wiele narzędzi z dokładnymi maskami. Sprawdziliśmy mocną wersję tego pomysłu:
H1. Model wytrenowany tylko na syntetycznych narzędziach nie jest gorszy na prawdziwych narzędziach od tego samego modelu wytrenowanego na prawdziwych oznaczeniach.
Hipotezę, margines i regułę decyzji ustalono w dokumencie projektowym (RFC 0001) przed jakimkolwiek treningiem.
Jak to sprawdziliśmy
- Dane syntetyczne. Modele chwytaka i haczyka w kształcie litery L zbudowano w Blenderze i wyrenderowano 20 000 razy z dokładnymi maskami. Rendery nałożono na 717 klatek bez narzędzi z publicznego zbioru CholecT50, z których każdą sprawdził człowiek. Augmentacje: światło, rozmycie, tkanka na końcówce, ciemna krawędź obrazu endoskopu i symulowany dym.
- Dane prawdziwe. CholecSeg8k: 4000 oznaczonych klatek z 8 nagrań do treningu i 1120 klatek z 2 nagrań do walidacji.
- Test. 7 nagrań CholecSeg8k, które nigdy nie były syntetycznym tłem, łącznie 2960 klatek. Przed pierwszym uruchomieniem na teście człowiek przejrzał każdy klip testowy w poszukiwaniu narzędzi bez własnej klasy. Nie trzeba było niczego wykluczać.
- Model. W każdym wariancie ten sam DeepLabV3-ResNet50, te same ustawienia i ta sama liczba kroków treningu. Każdy wariant uruchomiono z 3 ziarnami losowości.
| Wariant | Trening na |
|---|---|
| A | tylko syntetyczne narzędzia |
| B | tylko prawdziwe oznaczenia |
| C10 / C25 / C50 / C100 | model wariantu A, potem 10 / 25 / 50 / 100 % prawdziwych klatek |
- Wybór modelu. Wariant A wybierał punkt kontrolny tylko na syntetycznych danych walidacyjnych, więc żadne prawdziwe oznaczenie nie trafiło do wariantu syntetycznego.
- Uruchomienia na teście. Każdy wybrany punkt kontrolny uruchomiono na nagraniach testowych dokładnie raz, a każde uruchomienie zapisano.
Wyniki
Miarą jest pokrycie (IoU) maski narzędzi na wszystkich pikselach testu. 1 oznacza idealne pokrycie. Zakres to 95-procentowy przedział po nagraniach testowych i ziarnach.
| Wariant | Prawdziwe oznaczenia | IoU | Przedział 95 % |
|---|---|---|---|
| A, tylko syntetyka | 0 % | 0,116 | 0,04 – 0,19 |
| C10 | 10 % | 0,775 | 0,66 – 0,83 |
| C25 | 25 % | 0,767 | 0,63 – 0,83 |
| C50 | 50 % | 0,778 | 0,65 – 0,84 |
| C100 | 100 % | 0,764 | 0,62 – 0,84 |
| B, tylko prawdziwe | 100 % | 0,772 | 0,65 – 0,84 |
H1 odrzucona. Wariant A jest o 65,5 punktu za wariantem B, z 95-procentowym przedziałem od −75,9 do −53,5. Projekt dopuszczał różnicę najwyżej 2 punktów.
Model czysto syntetyczny nauczył się zadania syntetycznego: na syntetycznych danych walidacyjnych osiągnął 0,96. Na prawdziwych klatkach walidacyjnych uzyskał około 0,45, a na nagraniach testowych 0,12. Sprawdziliśmy jedno wyjaśnienie: że zapamiętał tkanki operacji walidacyjnych z teł. Tylko 29 z 717 teł pochodzi z tych operacji, więc to nie tłumaczy różnicy. Dlaczego model zawodzi na prawdziwych narzędziach, na razie nie wiadomo.
Dane w tabeli
| Epoka | Walidacja syntetyczna, średnia | Walidacja prawdziwa, średnia |
|---|---|---|
| 1 | 0,912 | 0,431 |
| 2 | 0,925 | 0,399 |
| 3 | 0,938 | 0,386 |
| 4 | 0,941 | 0,399 |
| 5 | 0,944 | 0,363 |
| 6 | 0,949 | 0,467 |
| 7 | 0,949 | 0,412 |
| 8 | 0,953 | 0,442 |
| 9 | 0,953 | 0,346 |
| 10 | 0,956 | 0,383 |
| 11 | 0,957 | 0,334 |
| 12 | 0,958 | 0,409 |
| 13 | 0,959 | 0,383 |
| 14 | 0,960 | 0,403 |
| 15 | 0,961 | 0,394 |
| 16 | 0,962 | 0,364 |
| 17 | 0,963 | 0,398 |
| 18 | 0,963 | 0,438 |
| 19 | 0,963 | 0,429 |
| 20 | 0,963 | 0,442 |
Sześć klatek walidacyjnych
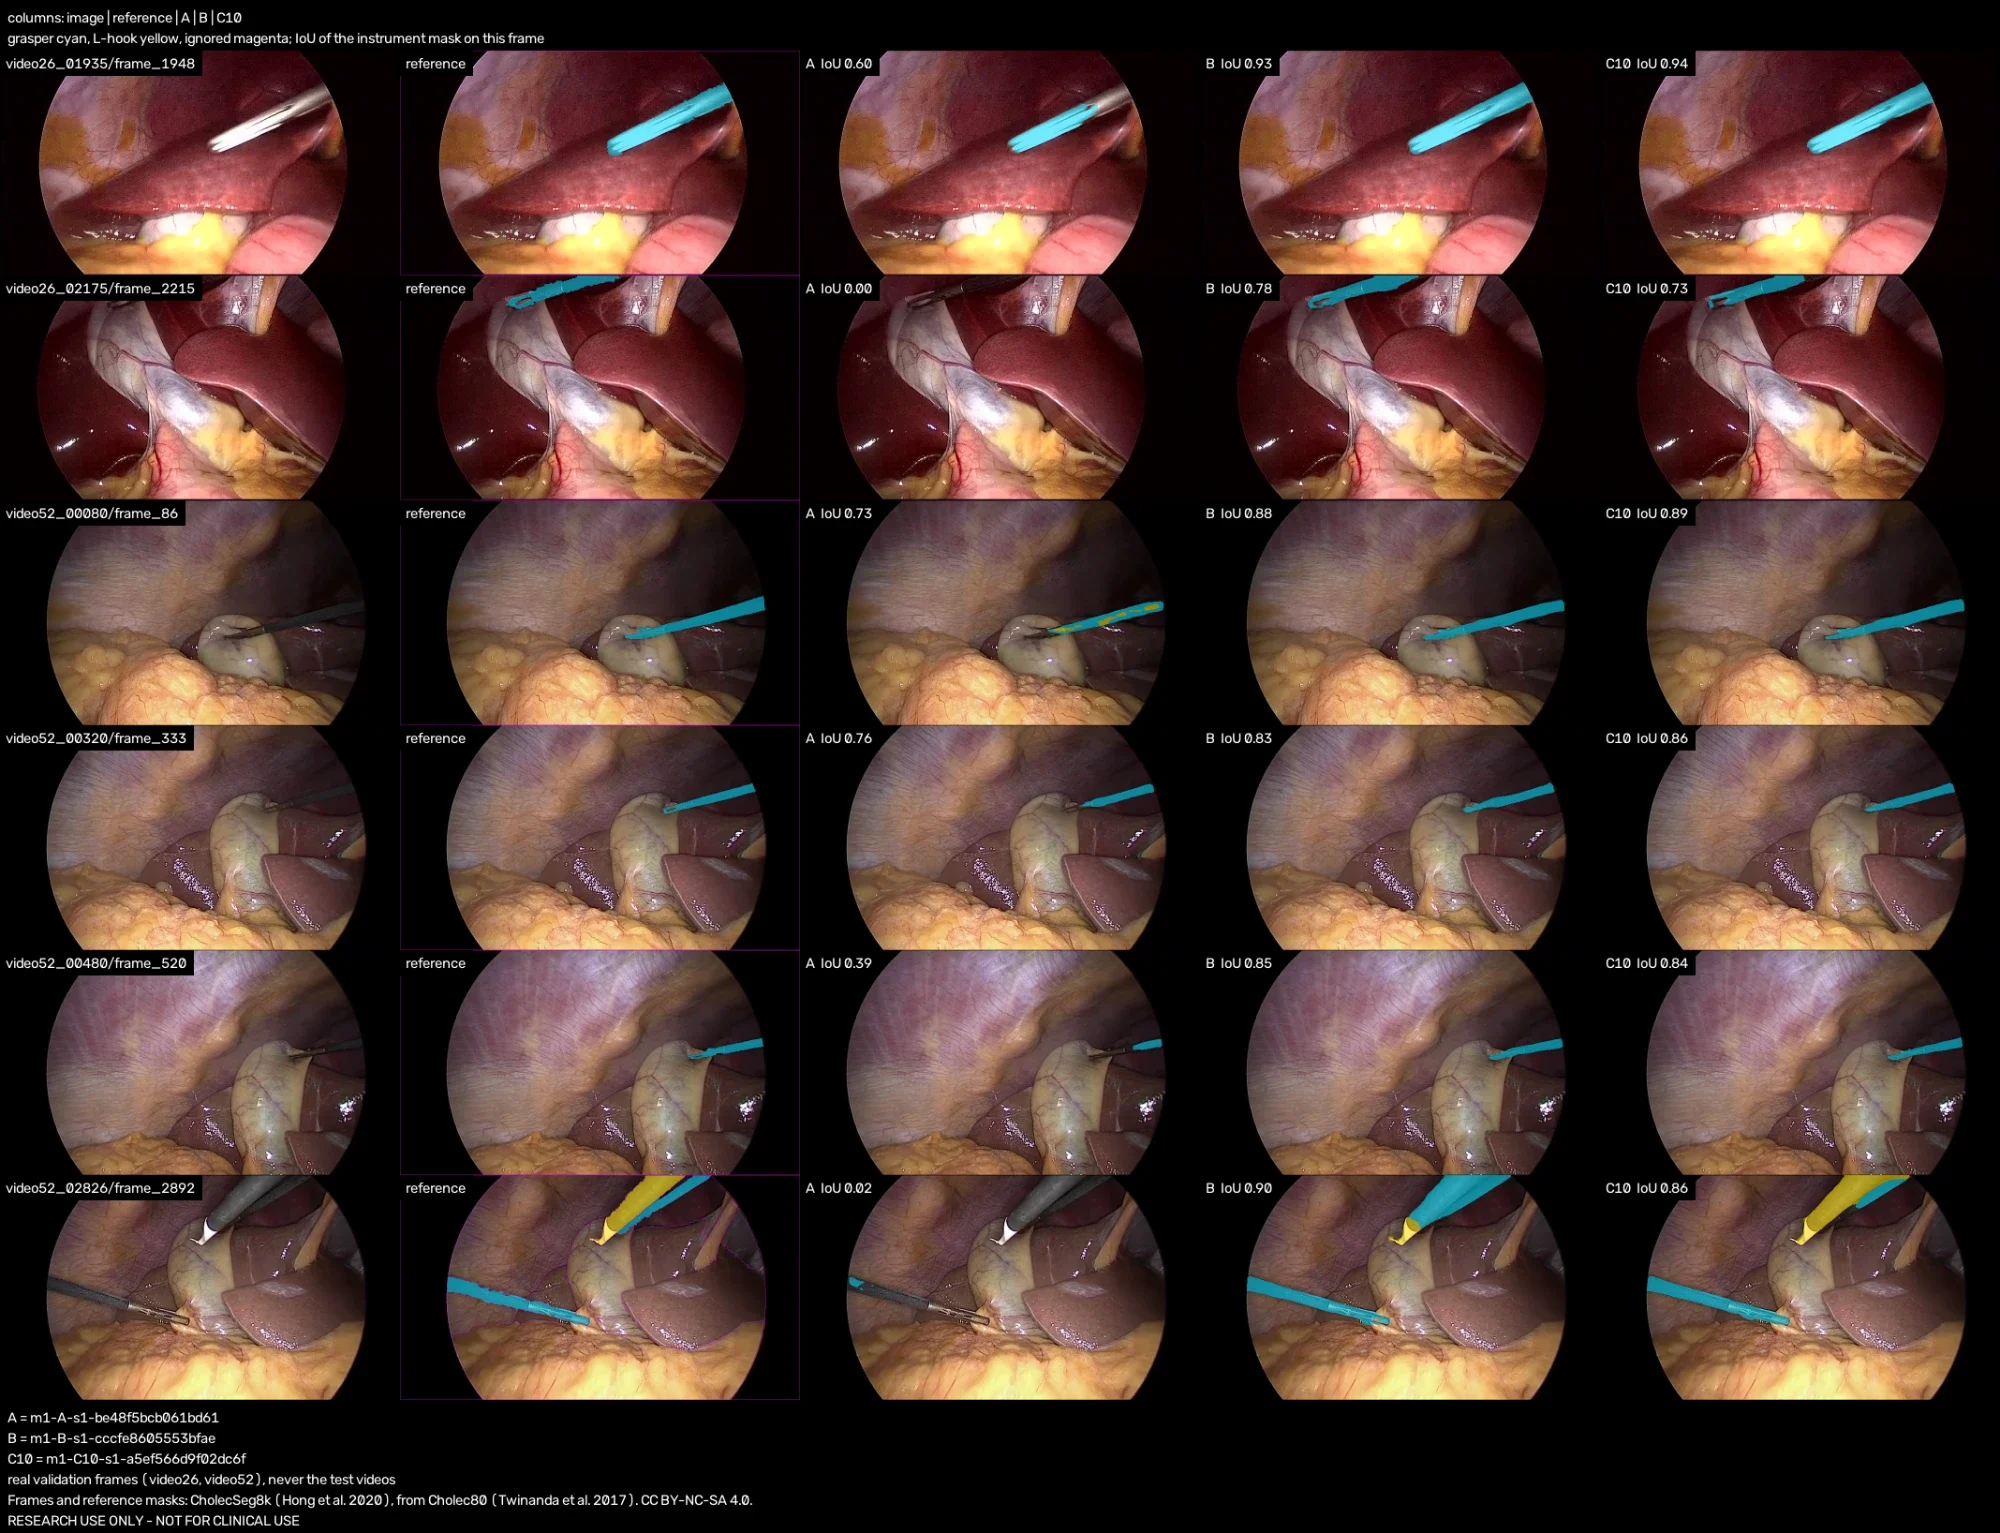
Rysunek pokazuje, co przewidują modele wariantów A, B i C10 (ziarno 1) na sześciu prawdziwych klatkach walidacyjnych. Klatki rozmieszczono równomiernie i ustalono, zanim zobaczyliśmy jakiekolwiek przewidywanie. Klatek testowych tu nie ma: ponowne uruchomienie na nich modeli byłoby kolejnym użyciem testu.
- Tam, gdzie chwytak odcina się od tkanki, wariant A znajduje jego część (IoU od 0,39 do 0,76).
- Tam, gdzie narzędzie jest przy krawędzi pola widzenia albo ma ciemny trzon (wiersze 2 i 6), wariant A nie znajduje prawie nic (0,00 i 0,02). Warianty B i C10 znajdują te narzędzia (od 0,73 do 0,90).
- Na ostatniej klatce wariant B oznacza haczyk w kształcie L jako chwytak, a C10 rozpoznaje go poprawnie. IoU maski narzędzi nie uwzględnia klasy.
Sześć klatek ilustruje powyższe liczby. Same w sobie niczego nie dowodzą.
Czym te liczby nie są
- Nie są dowodem, że syntetyczny pretrening oszczędza oznaczenia. Warianty C doganiają wariant B już przy 10 % prawdziwych klatek, około 400, i dalej nic nie zyskują. Ale w projekcie nie było wariantu wytrenowanego na tych samych 10 % bez kroku syntetycznego. Bez niego nie wiemy, czy krok syntetyczny pomógł, czy 400 prawdziwych klatek wystarcza samo.
- Nie są werdyktem o danych syntetycznych w ogóle. Dotyczą tego renderera, tych narzędzi i 717 teł, czyli mniej niż planowane około 1000.
- Nie są wynikiem klinicznym. Szybkości, odblasków i krwi nie mierzono osobno, a żaden model nie został opublikowany.
RESEARCH USE ONLY – NOT FOR CLINICAL USE (wyłącznie do badań, nie do użytku klinicznego).
Co poszło nie tak po drodze
- Pierwsze rendery były trzy razy wolniejsze, niż musiały. Odszumianie działało na CPU, a GPU czekało. Po poprawce 20 000 renderów zajęło około 3 godzin.
- Wariant syntetyczny przerywał się po kilku epokach. Część obrazów dymu uszkodziła się przy kopiowaniu na serwer z GPU. Uruchomienia wznowiono od ostatniego punktu kontrolnego, a teraz każdy obraz jest sprawdzany przed rozpoczęciem treningu.
- Sześć uruchomień dostrajania wystartowało z nieukończonych modeli z powodu tej awarii. Oznaczono je jako nieważne, nigdy nie uruchomiono ich na teście, a kod treningu teraz ich nie przyjmuje.
Możliwe dalsze kroki
- Wariant kontrolny na 10 % i 25 % prawdziwych klatek bez kroku syntetycznego. To najtańszy sposób, by sprawdzić, co daje krok syntetyczny.
- Randomizacja domeny: celowo nierealistyczne tekstury i kolory, by sprawdzić, czy różnica wynika z wyglądu.
Pełna karta modelu z identyfikatorami uruchomień znajduje się w repozytorium projektu. Zobacz też dziennik eksperymentów i dlaczego wyniki negatywne mają znaczenie.