
La question
Les annotations au pixel de la vidéo chirurgicale sont longues à produire, et les contours des instruments en sont la partie la moins cohérente. Un moteur de rendu fournit autant d’instruments que l’on veut, avec des masques exacts. Nous avons testé la version forte de cette idée :
H1. Un modèle entraîné uniquement sur des instruments synthétiques n’est pas moins bon, sur des instruments réels, que le même modèle entraîné sur des annotations réelles.
L’hypothèse, la marge et la règle de décision ont été fixées dans un document de conception (RFC 0001) avant tout entraînement.
Comment nous l’avons testé
- Données synthétiques. Des modèles d’une pince à préhension et d’un crochet en L ont été construits dans Blender et rendus 20 000 fois avec des masques exacts. Les rendus ont été posés sur 717 images sans instrument du jeu de données public CholecT50, vérifiées une à une par une personne. Augmentations : lumière, flou, tissu sur la pointe, bord sombre de l’image endoscopique et fumée simulée.
- Données réelles. CholecSeg8k : 4 000 images annotées de 8 vidéos pour l’entraînement et 1 120 images de 2 vidéos pour la validation.
- Test. Les 7 vidéos de CholecSeg8k qui n’ont jamais servi de fond synthétique, soit 2 960 images. Avant la première exécution sur le test, une personne a examiné chaque clip de test à la recherche d’instruments sans classe propre. Rien n’a dû être exclu.
- Modèle. Le même DeepLabV3-ResNet50, les mêmes réglages et le même nombre de pas d’entraînement dans chaque bras. Chaque bras a tourné avec 3 graines.
| Bras | Entraîné sur |
|---|---|
| A | instruments synthétiques uniquement |
| B | annotations réelles uniquement |
| C10 / C25 / C50 / C100 | le modèle du bras A, puis 10 / 25 / 50 / 100 % des images réelles |
- Choix du modèle. Le bras A a choisi son point de contrôle sur les seules données de validation synthétiques, si bien qu’aucune annotation réelle n’a atteint le bras synthétique.
- Exécutions sur le test. Chaque point de contrôle retenu a été exécuté exactement une fois sur les vidéos de test, et chaque exécution est enregistrée.
Résultats
La mesure est le recouvrement (IoU) du masque des instruments sur tous les pixels du test. 1 est parfait. La plage est un intervalle à 95 % sur les vidéos de test et les graines.
| Bras | Annotations réelles | IoU | Intervalle à 95 % |
|---|---|---|---|
| A, synthétique seul | 0 % | 0,116 | 0,04 – 0,19 |
| C10 | 10 % | 0,775 | 0,66 – 0,83 |
| C25 | 25 % | 0,767 | 0,63 – 0,83 |
| C50 | 50 % | 0,778 | 0,65 – 0,84 |
| C100 | 100 % | 0,764 | 0,62 – 0,84 |
| B, réel seul | 100 % | 0,772 | 0,65 – 0,84 |
H1 est rejetée. Le bras A a 65,5 points de retard sur le bras B, avec un intervalle à 95 % de −75,9 à −53,5. La conception tolérait un écart de 2 points au plus.
Le modèle purement synthétique a appris la tâche synthétique : il a atteint 0,96 sur les données de validation synthétiques. Sur les images réelles de validation, il a obtenu environ 0,45, et sur les vidéos de test 0,12. Nous avons vérifié une explication : qu’il aurait mémorisé le tissu des opérations de validation à travers les fonds. Seuls 29 des 717 fonds proviennent de ces opérations, cela n’explique donc pas l’écart. On ne sait pas encore pourquoi le modèle échoue sur les instruments réels.
Données sous forme de tableau
| Époque | Validation synthétique, moyenne | Validation réelle, moyenne |
|---|---|---|
| 1 | 0,912 | 0,431 |
| 2 | 0,925 | 0,399 |
| 3 | 0,938 | 0,386 |
| 4 | 0,941 | 0,399 |
| 5 | 0,944 | 0,363 |
| 6 | 0,949 | 0,467 |
| 7 | 0,949 | 0,412 |
| 8 | 0,953 | 0,442 |
| 9 | 0,953 | 0,346 |
| 10 | 0,956 | 0,383 |
| 11 | 0,957 | 0,334 |
| 12 | 0,958 | 0,409 |
| 13 | 0,959 | 0,383 |
| 14 | 0,960 | 0,403 |
| 15 | 0,961 | 0,394 |
| 16 | 0,962 | 0,364 |
| 17 | 0,963 | 0,398 |
| 18 | 0,963 | 0,438 |
| 19 | 0,963 | 0,429 |
| 20 | 0,963 | 0,442 |
Six images de validation
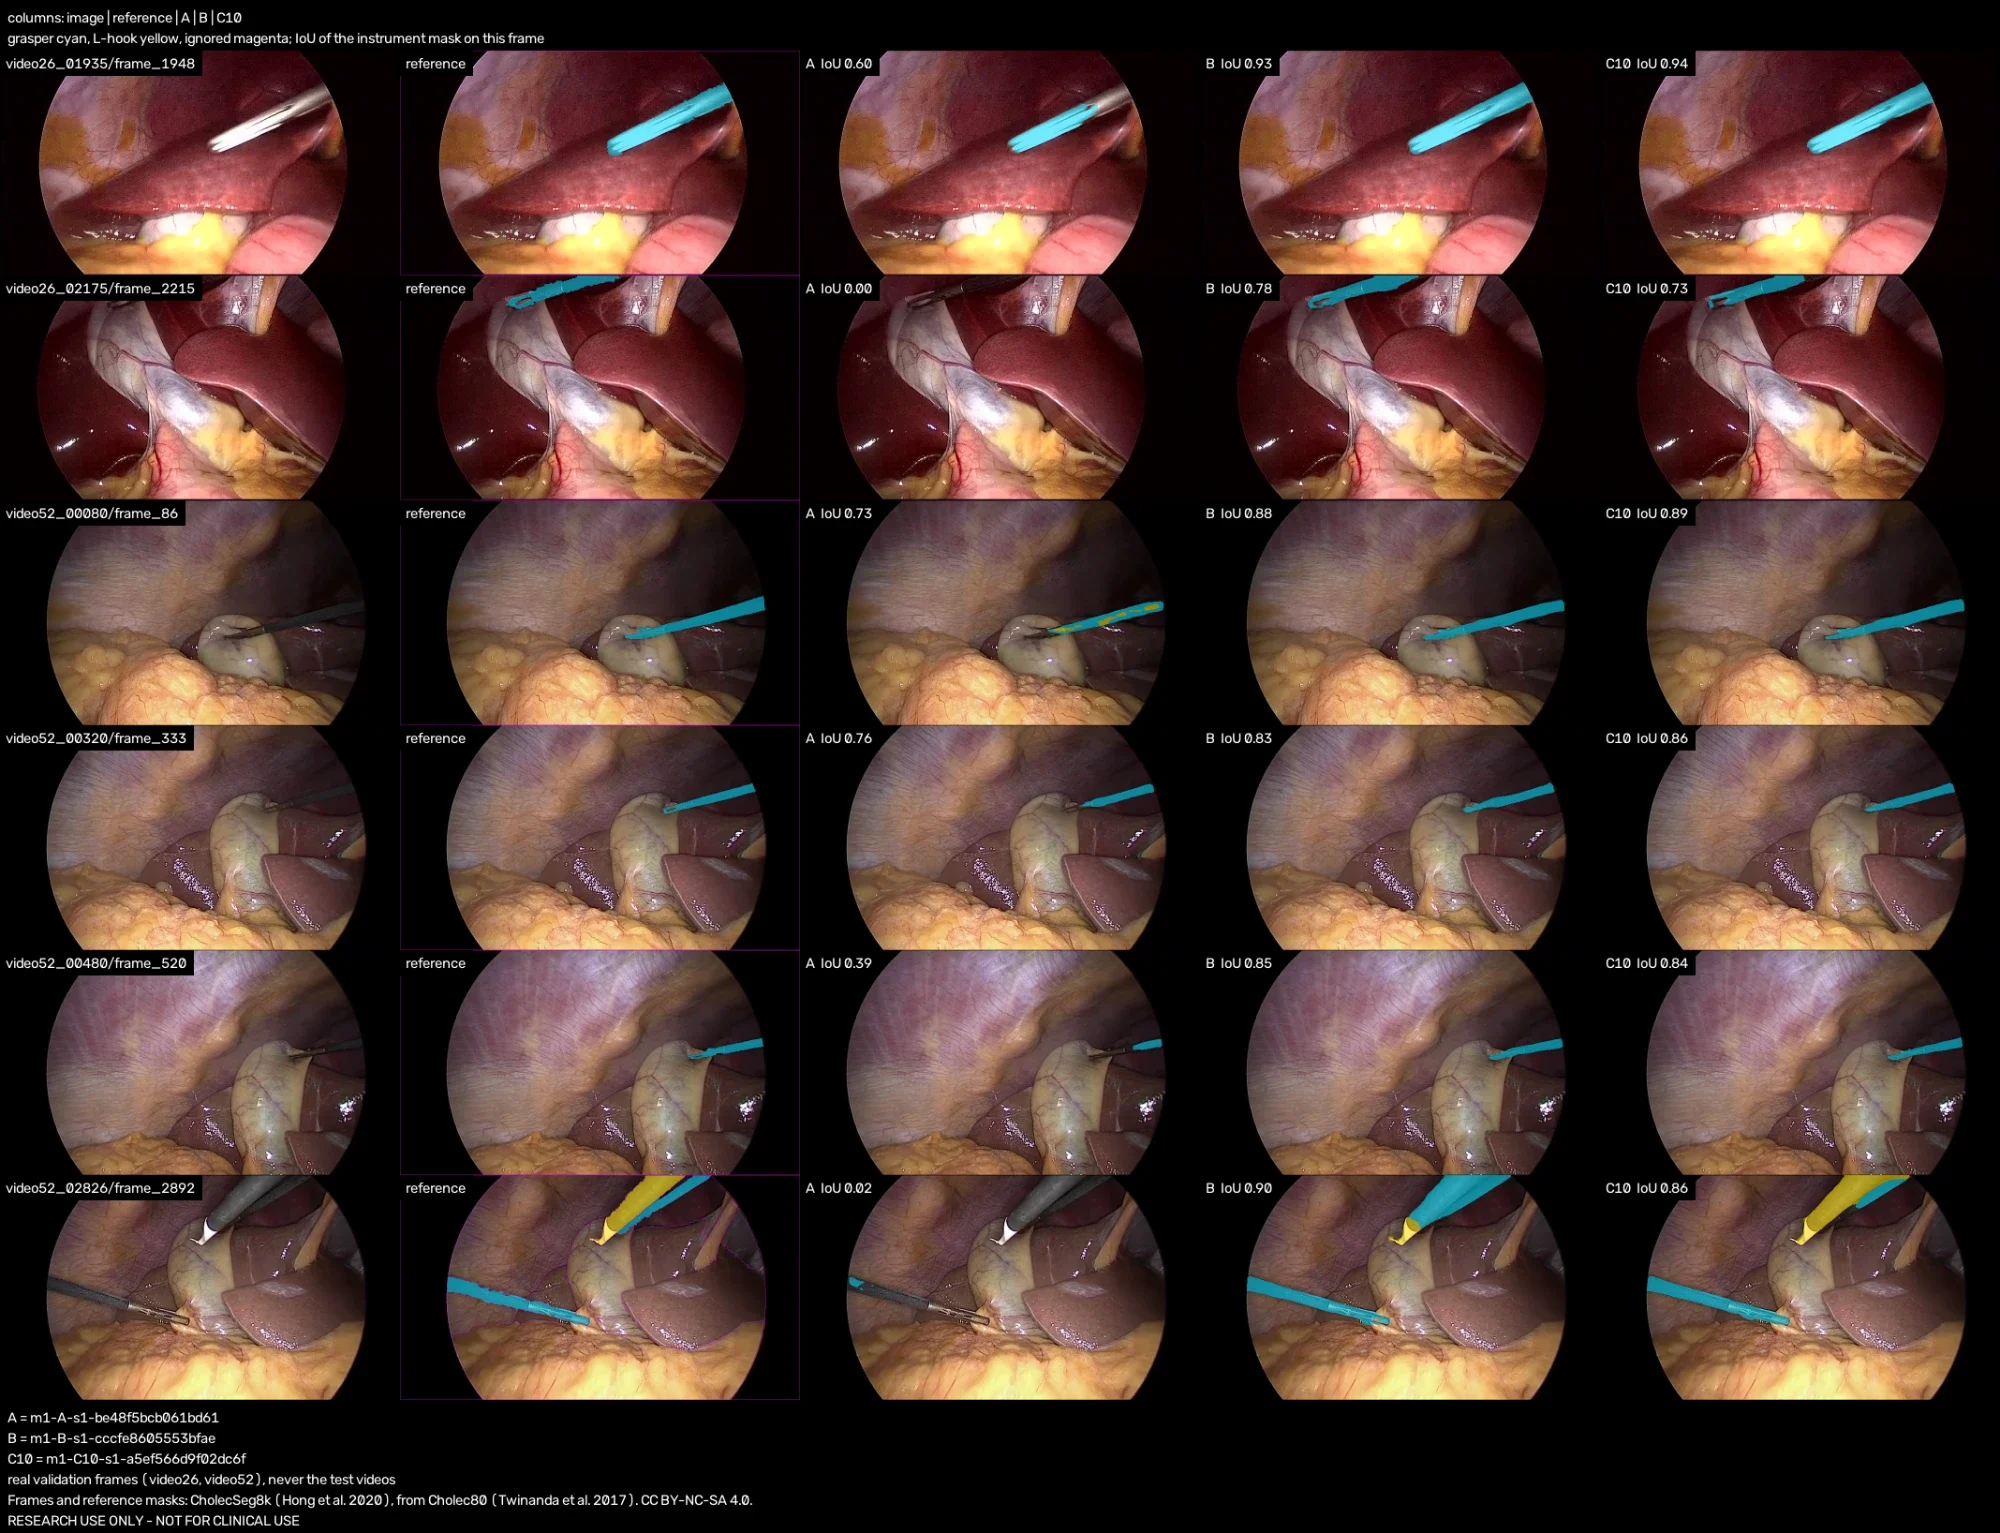
La figure montre ce que prédisent les modèles des bras A, B et C10 (graine 1) sur six images réelles de validation. Les images sont régulièrement espacées et ont été fixées avant de voir la moindre prédiction. Aucune image de test n’est montrée : y exécuter à nouveau les modèles reviendrait à utiliser le test une fois de plus.
- Là où une pince se détache du tissu, le bras A en trouve une partie (IoU de 0,39 à 0,76).
- Là où l’instrument est au bord du champ ou a une tige sombre (lignes 2 et 6), le bras A ne trouve presque rien (0,00 et 0,02). Les bras B et C10 trouvent ces instruments (de 0,73 à 0,90).
- Sur la dernière image, le bras B marque le crochet en L comme une pince, et C10 le classe correctement. L’IoU du masque des instruments ne tient pas compte de la classe.
Six images illustrent les chiffres ci-dessus. À elles seules, elles ne prouvent rien.
Ce que ces chiffres ne sont pas
- Pas une preuve que le pré-entraînement synthétique économise des annotations. Les bras C rejoignent le bras B dès 10 % des images réelles, environ 400 images, et ne gagnent rien au-delà. Mais la conception ne comportait pas de bras entraîné sur ces mêmes 10 % sans l’étape synthétique. Sans lui, impossible de dire si l’étape synthétique a aidé ou si 400 images réelles suffisent à elles seules.
- Pas un verdict sur les données synthétiques en général. Il vaut pour ce moteur de rendu, ces instruments et 717 fonds, moins que les quelque 1 000 prévus.
- Pas un résultat clinique. La vitesse, les reflets et le sang n’ont pas été mesurés séparément, et aucun modèle n’est publié.
RESEARCH USE ONLY – NOT FOR CLINICAL USE (recherche uniquement, pas d’usage clinique).
Ce qui a mal tourné en chemin
- Les premiers rendus étaient trois fois plus lents que nécessaire. Le débruitage tournait sur le CPU pendant que le GPU attendait. Après correction, 20 000 rendus ont pris environ 3 heures.
- Le bras synthétique s’est arrêté au bout de quelques époques. Certaines images de fumée avaient été endommagées lors de leur copie vers le serveur GPU. Les exécutions ont repris à leur dernier point de contrôle, et chaque image est désormais vérifiée avant le début de l’entraînement.
- Six affinages sont partis de modèles inachevés à cause de cet arrêt. Ils ont été marqués comme invalides, jamais exécutés sur le test, et le code d’entraînement les refuse désormais.
Prochaines étapes possibles
- Un bras de contrôle entraîné sur 10 % et 25 % des images réelles sans l’étape synthétique. C’est le moyen le moins coûteux de savoir ce qu’apporte l’étape synthétique.
- La randomisation de domaine : des textures et des couleurs volontairement irréalistes, pour vérifier si l’écart tient à l’apparence.
La fiche complète du modèle, avec les identifiants d’exécution, se trouve dans le dépôt du projet. Voir aussi le journal des expériences et pourquoi les résultats négatifs comptent.