
Die Frage
Pixelgenaue Annotationen für chirurgische Videos sind aufwendig, und die Instrumentengrenzen sind ihr ungenauester Teil. Ein Renderer liefert beliebig viele Instrumente mit exakten Masken. Wir haben die starke Form dieser Idee getestet:
H1. Ein Modell, das nur mit synthetischen Instrumenten trainiert wurde, ist bei echten Instrumenten nicht schlechter als dasselbe Modell mit echten Annotationen.
Hypothese, Toleranz und Entscheidungsregel wurden vor dem ersten Trainingslauf in einem Designdokument (RFC 0001) festgelegt.
Wie wir getestet haben
- Synthetische Daten. Modelle einer Fasszange und eines L-Hakens wurden in Blender gebaut und 20.000-mal mit exakten Masken gerendert. Die Renderings wurden über 717 Bilder des öffentlichen Datensatzes CholecT50 ohne Instrumente gelegt, die jeweils von einem Menschen geprüft wurden. Augmentierungen: Licht, Unschärfe, Gewebe über der Spitze, der dunkle Rand des Endoskopbilds und simulierter Rauch.
- Echte Daten. CholecSeg8k: 4.000 annotierte Bilder aus 8 Videos zum Training und 1.120 Bilder aus 2 Videos zur Validierung.
- Test. Die 7 CholecSeg8k-Videos, die nie als synthetischer Hintergrund dienten, insgesamt 2.960 Bilder. Vor dem ersten Testlauf hat ein Mensch jeden Testclip auf Instrumente ohne eigene Klasse geprüft. Ausgeschlossen werden musste nichts.
- Modell. In jedem Arm dasselbe DeepLabV3-ResNet50, dieselben Einstellungen und dieselbe Zahl an Trainingsschritten. Jeder Arm lief mit 3 Seeds.
| Arm | Trainiert auf |
|---|---|
| A | nur synthetische Instrumente |
| B | nur echte Annotationen |
| C10 / C25 / C50 / C100 | das Modell von Arm A, danach 10 / 25 / 50 / 100 % der echten Bilder |
- Modellauswahl. Arm A wählte seinen Checkpoint nur auf synthetischen Validierungsdaten, sodass keine echte Annotation in den synthetischen Arm gelangte.
- Testläufe. Jeder gewählte Checkpoint lief genau einmal auf den Testvideos, und jeder Lauf ist protokolliert.
Ergebnisse
Die Metrik ist die Überlappung (IoU) der Instrumentenmaske über alle Testpixel. 1 ist perfekt. Der Bereich ist ein 95-%-Intervall über Testvideos und Seeds.
| Arm | Echte Annotationen | IoU | 95-%-Intervall |
|---|---|---|---|
| A, nur synthetisch | 0 % | 0,116 | 0,04 – 0,19 |
| C10 | 10 % | 0,775 | 0,66 – 0,83 |
| C25 | 25 % | 0,767 | 0,63 – 0,83 |
| C50 | 50 % | 0,778 | 0,65 – 0,84 |
| C100 | 100 % | 0,764 | 0,62 – 0,84 |
| B, nur echt | 100 % | 0,772 | 0,65 – 0,84 |
H1 ist widerlegt. Arm A liegt 65,5 Punkte hinter Arm B, mit einem 95-%-Intervall von −75,9 bis −53,5. Das Design ließ höchstens 2 Punkte Abstand zu.
Das rein synthetische Modell hat die synthetische Aufgabe gelernt: Auf synthetischen Validierungsdaten erreichte es 0,96. Auf echten Validierungsbildern kam es auf etwa 0,45, auf den Testvideos auf 0,12. Eine Erklärung haben wir geprüft: dass es das Gewebe der Validierungsoperationen über die Hintergründe auswendig gelernt hat. Nur 29 der 717 Hintergründe stammen aus diesen Operationen, das erklärt den Abstand also nicht. Warum das Modell an echten Instrumenten scheitert, ist noch nicht bekannt.
Daten als Tabelle
| Epoche | Synthetische Validierung, Mittel | Echte Validierung, Mittel |
|---|---|---|
| 1 | 0,912 | 0,431 |
| 2 | 0,925 | 0,399 |
| 3 | 0,938 | 0,386 |
| 4 | 0,941 | 0,399 |
| 5 | 0,944 | 0,363 |
| 6 | 0,949 | 0,467 |
| 7 | 0,949 | 0,412 |
| 8 | 0,953 | 0,442 |
| 9 | 0,953 | 0,346 |
| 10 | 0,956 | 0,383 |
| 11 | 0,957 | 0,334 |
| 12 | 0,958 | 0,409 |
| 13 | 0,959 | 0,383 |
| 14 | 0,960 | 0,403 |
| 15 | 0,961 | 0,394 |
| 16 | 0,962 | 0,364 |
| 17 | 0,963 | 0,398 |
| 18 | 0,963 | 0,438 |
| 19 | 0,963 | 0,429 |
| 20 | 0,963 | 0,442 |
Sechs Validierungsbilder
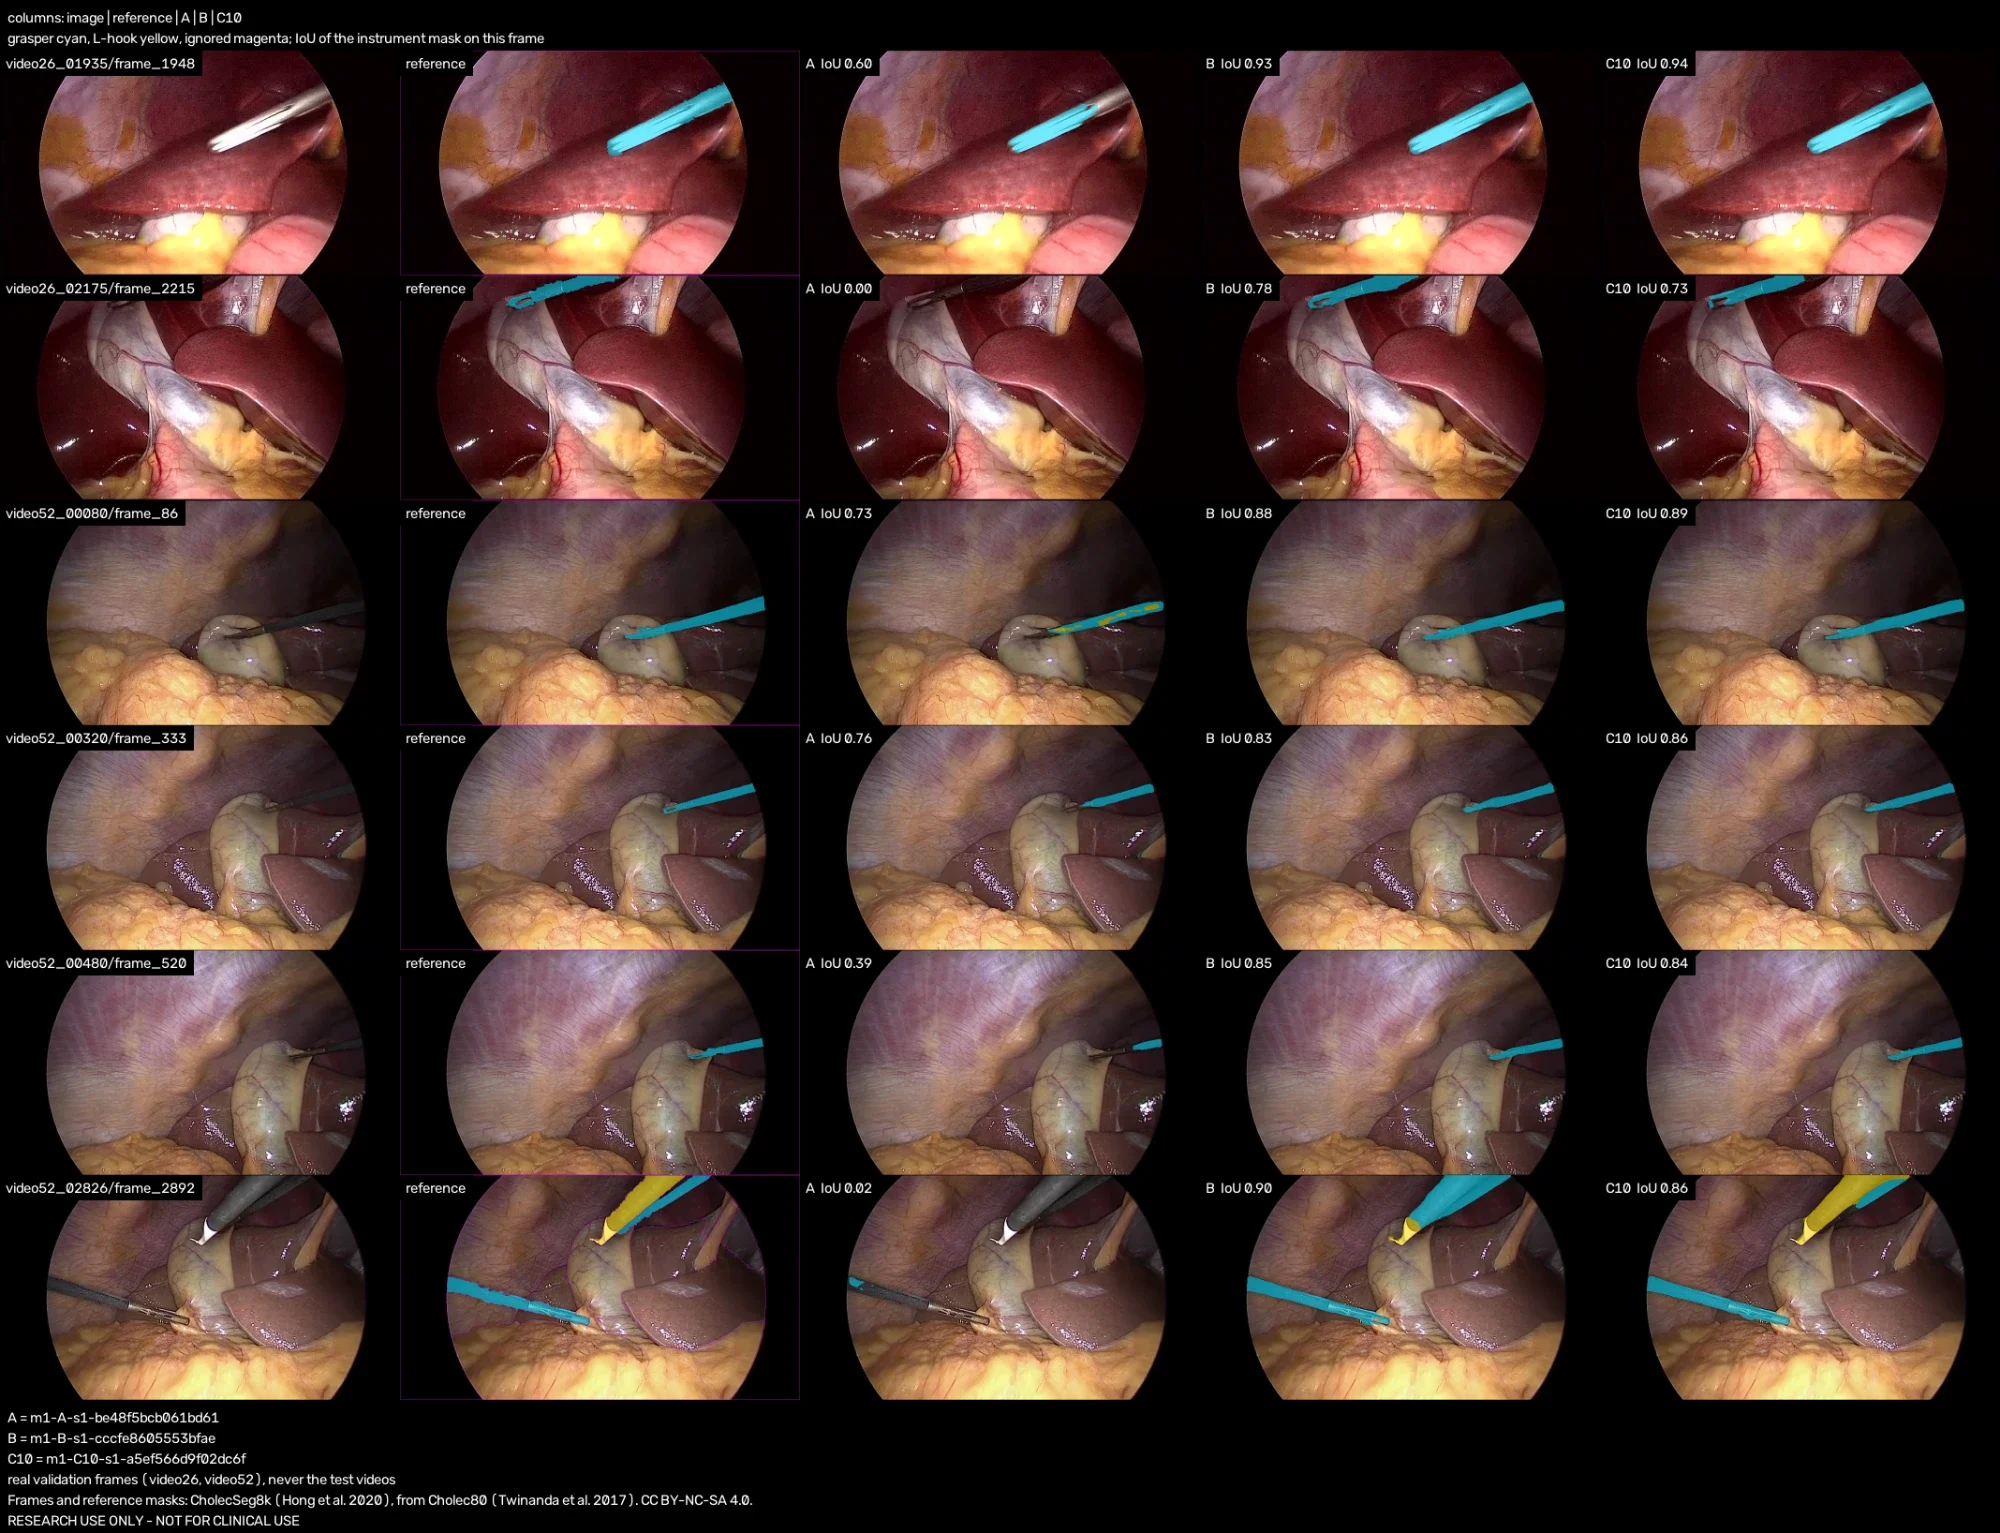
Die Abbildung zeigt, was die Modelle der Arme A, B und C10 (Seed 1) auf sechs echten Validierungsbildern vorhersagen. Die Bilder liegen in gleichen Abständen und wurden festgelegt, bevor eine Vorhersage zu sehen war. Testbilder sind nicht dabei: Die Modelle erneut darauf laufen zu lassen, wäre eine weitere Nutzung des Tests.
- Wo sich eine Fasszange vom Gewebe abhebt, findet Arm A einen Teil davon (IoU 0,39 bis 0,76).
- Wo das Instrument am Rand des Bildes liegt oder einen dunklen Schaft hat (Zeilen 2 und 6), findet Arm A fast nichts (0,00 und 0,02). Die Arme B und C10 finden diese Instrumente (0,73 bis 0,90).
- Im letzten Bild markiert Arm B den L-Haken als Fasszange, C10 erkennt ihn richtig. Die IoU der Instrumentenmaske berücksichtigt die Klasse nicht.
Sechs Bilder veranschaulichen die Zahlen oben. Für sich allein sind sie kein Beleg.
Was diese Zahlen nicht sind
- Kein Beleg, dass synthetisches Vortraining Annotationen spart. Die C-Arme erreichen Arm B schon mit 10 % der echten Bilder, etwa 400 Bildern, und gewinnen darüber hinaus nichts. Das Design enthielt aber keinen Arm, der auf denselben 10 % ohne den synthetischen Schritt trainiert wurde. Ohne ihn lässt sich nicht sagen, ob der synthetische Schritt geholfen hat oder ob 400 echte Bilder allein genügen.
- Kein Urteil über synthetische Daten im Allgemeinen. Es gilt für diesen Renderer, diese Instrumente und 717 Hintergründe, weniger als die etwa 1.000 geplanten.
- Kein klinisches Ergebnis. Geschwindigkeit, Spiegelungen und Blut wurden nicht gesondert gemessen, und kein Modell ist veröffentlicht.
RESEARCH USE ONLY – NOT FOR CLINICAL USE (nur für die Forschung, nicht für den klinischen Einsatz).
Was unterwegs schiefging
- Die ersten Renderings waren dreimal langsamer als nötig. Die Rauschunterdrückung lief auf der CPU, während die GPU wartete. Nach der Korrektur dauerten 20.000 Renderings etwa 3 Stunden.
- Der synthetische Arm stürzte nach wenigen Epochen ab. Einige Rauchbilder waren beim Kopieren auf den GPU-Server beschädigt worden. Die Läufe wurden vom letzten Checkpoint fortgesetzt, und jedes Bild wird jetzt vor dem Trainingsstart geprüft.
- Sechs Feinabstimmungsläufe starteten von unfertigen Modellen, eine Folge dieses Absturzes. Sie wurden als ungültig markiert, nie auf dem Test ausgeführt, und der Trainingscode verweigert sie jetzt.
Mögliche nächste Schritte
- Ein Kontrollarm mit 10 % und 25 % der echten Bilder ohne den synthetischen Schritt. Das ist der günstigste Weg herauszufinden, was der synthetische Schritt beiträgt.
- Domain Randomization: absichtlich unrealistische Texturen und Farben, um zu prüfen, ob der Abstand am Aussehen liegt.
Die vollständige Modellkarte mit den Kennungen der Durchläufe liegt im Repository des Projekts. Siehe auch das Experiment-Protokoll und warum negative Ergebnisse zählen.